기술편 · 네트워크 슬라이싱 운영 실패
네트워크 슬라이싱 운영은 어디에서 실패하는가
Network Slicing 운영 실패를 단순 장애 목록이 아니라 측정·정책·변경·책임·조직·고객 약속의 연결이 끊어지는 구조로 보고, 탐지·중지·rollback·재검증의 복구 조건을 살핀다.
글 · TelcoNexus최초 발행 조회수 확인 중
AI가 telemetry를 정리하고 원인 후보를 좁히며 제한된 변경과 재검증을 도울 수 있어도, Network Slicing 운영이 저절로 안전해지는 것은 아니다. 앞 글의 운영 loop는 관측, 분석, 판단, 정책 실행, assurance, human exception이 이어질 때만 작동한다. 어느 한 단계가 정확해도 다음 단계로 의미·권한·책임이 전달되지 않으면 loop는 닫히지 않는다.
그래서 운영 실패를 장비 고장이나 KPI 하락 목록으로만 보면 절반을 놓친다. 측정은 정상인데 계약과 다른 대상을 보고 있을 수 있고, 정책은 맞는데 서로 충돌할 수 있으며, 변경은 성공 응답을 냈지만 고객 경험을 악화시킬 수 있다. 기술팀이 원인을 찾아도 중지 권한자가 불명확하면 영향은 계속된다. 고객에게 약속한 지표와 운영팀이 보는 지표가 다르면 복구 뒤에도 분쟁은 남는다.
필자는 Network Slicing 운영 실패를 **기술적 사건이 측정·정책·변경·책임·조직·고객 약속의 연결 단절을 만나 서비스 영향으로 확대되는 구조**로 봐야 한다고 본다. 여기서 특정 상용 장애 사례를 일반화하지 않는다. 3GPP·ETSI·GSMA 문서는 관리 기능, KPI, closed-loop governance, 역할과 slice template의 근거다. 아래 실패 구조와 복구 순서는 이 근거를 연결한 운영 분석이다.
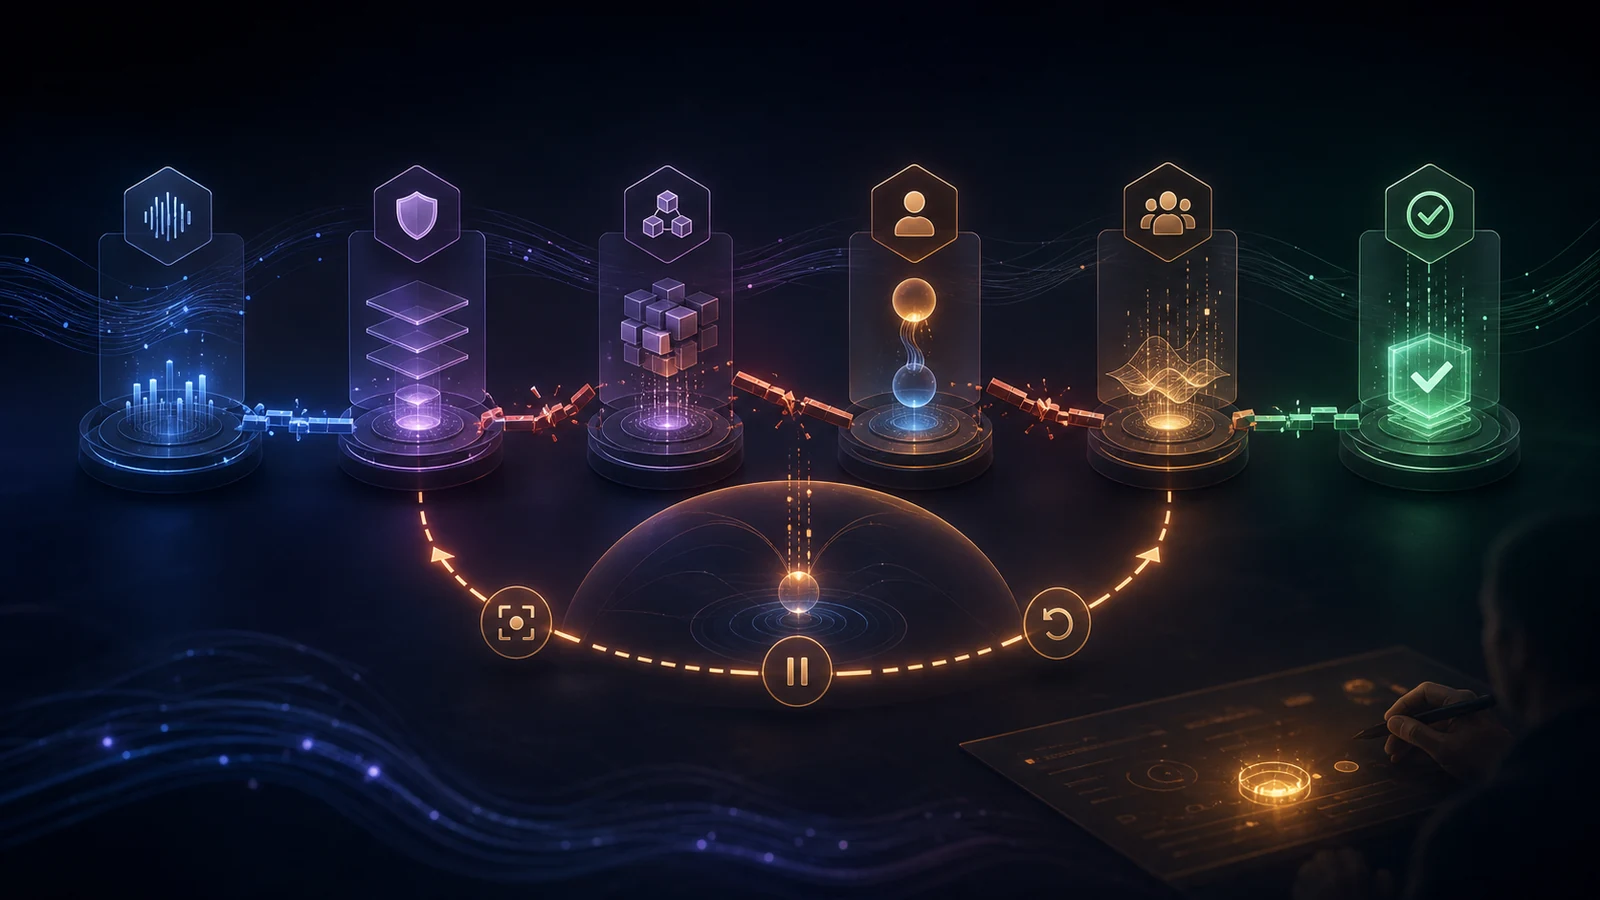
실패는 한 점이 아니라 연결이 끊어진 상태다
예를 들어 latency가 높아졌다는 alarm은 출발점일 뿐이다. 먼저 어느 측정점, 어느 S-NSSAI·지역·시간 구간·traffic class의 값인지 확인해야 한다. 그 값이 고객 SLS의 percentile·window·제외 조건과 일치하는지도 봐야 한다. 그다음 최근 configuration·policy·resource 변화와 연계하고, 다른 slice 또는 공유 domain에 미치는 영향을 확인해야 한다. 마지막으로 누가 변경을 멈추고 고객에게 어떤 상태를 설명할지까지 이어져야 운영 사건이 닫힌다.
3GPP TS 28.536은 communication service assurance의 closed control loop에서 data reception, SLS fulfillment 분석, action decision을 구분하고 NetworkSlice 또는 NetworkSliceSubnet을 관리 대상으로 둘 수 있게 한다. 이 구조는 관측값을 받아 목표 충족 여부를 판단하고 조치한 뒤 다시 확인할 수 있음을 보여 준다. 그러나 표준에 capability가 있다는 사실만으로 측정 정의, 조직의 중지 권한, 고객 통지가 자동으로 맞춰지는 것은 아니다.
3GPP TS 28.554는 network slice의 end-to-end delay, throughput, PDU session establishment time과 같은 KPI마다 측정 대상·단위·집계 방식을 구체화한다. 같은 이름의 지표라도 domain dashboard의 평균과 고객 SLS의 percentile이 다르면 서로 다른 사실을 말한다. 측정 failure는 센서가 완전히 꺼진 경우뿐 아니라, 값은 들어오지만 서비스 약속과 연결할 context가 빠진 경우도 포함한다.
기술적 failure, 운영·조직적 failure, 고객 영향은 분리해서 봐야 한다
첫째, **기술적 failure**는 packet loss, 지연 증가, session establishment 실패, resource exhaustion, NF·transport·RAN 이상, 잘못된 configuration처럼 시스템 동작과 측정 가능한 상태의 문제다. 탐지와 복구에는 정확한 식별자, 시간 정렬, dependency, 변경 이력과 재현 가능한 KPI가 필요하다.
둘째, **운영·조직적 failure**는 기술 신호를 action으로 바꾸는 연결이 끊어진 문제다. 충돌하는 policy의 우선순위가 없거나, 자동화가 서로 반대 action을 내거나, change owner와 rollback owner가 다르거나, 야간 incident에서 승인자가 응답하지 않는 상태가 여기에 속한다. 기술 component가 모두 살아 있어도 운영 체계는 실패할 수 있다.
셋째, **SLA/고객 영향**은 고객이 실제로 받은 서비스와 합의한 약속의 차이다. 고객 업무 중단, 사용 가능 지역 축소, 지연·신뢰성 저하, 관측 불가, 통지 지연, remedy 판단 불일치가 포함될 수 있다. network KPI 하락이 곧 SLA 위반이라는 뜻도 아니고, network KPI가 정상이라고 고객 영향이 없다는 뜻도 아니다. 적용 대상, 측정 window, KQI/KPI, 제외 조건과 고객 측 증거를 계약 정의에 맞춰 대조해야 한다.
이 세 경계는 원인을 미루기 위한 구분이 아니다. 기술팀은 component를 복구하고, 운영 조직은 action과 권한의 흐름을 복구하며, 고객 접점은 영향·통지·검증·remedy의 기록을 닫는다. 하나의 팀이나 도구가 세 층을 모두 대신한다고 가정하면 복구 완료 선언이 너무 빨라진다.
여섯 가지 실패 지점과 남는 책임
| 항목 | 설명 |
|---|---|
| 측정 실패 | 증상·원인: KPI 불일치·공백, 정의·시간·식별자 오류. 복구·책임: 원본과 영향 범위를 고정하고 측정 owner가 SLA 해석을 맡는다. |
| 정책 실패 | 증상·원인: action 충돌·진동, 목표·우선순위 충돌. 복구·책임: 자동 실행을 중지하고 policy owner가 예외를 승인한다. |
| 변경 실패 | 증상·원인: 성공 응답 뒤 서비스 악화, 영향 분석·검증 부족. 복구·책임: 변경을 중지·rollback하고 change owner가 감사 기록을 남긴다. |
| 책임 실패 | 증상·원인: 경보 미인수·대응 지연, RACI·호출 공백. 복구·책임: incident 지휘자를 지정하고 결정권·통지 책임을 고정한다. |
| 조직 실패 | 증상·원인: domain별 부분 최적화, 공동 목표·훈련 부족. 복구·책임: 공동 대응으로 전환하고 자원·runbook·훈련 책임을 보완한다. |
| 고객 약속 | 증상·원인: 내부 지표는 정상이나 고객 불만 지속, 지표·기간 불일치. 복구·책임: 고객 영향 범위를 함께 확인하고 설명·인수·remedy를 판정한다. |
표의 ‘근본 원인’은 사건 하나의 확정 원인이 아니라 조사해야 할 구조적 후보다. 실제 incident에서는 여러 행이 동시에 나타날 수 있다. 잘못된 measurement context가 policy 판단을 흐리고, 그 판단이 change로 실행되며, 소유권 공백 때문에 rollback이 늦어지고, 고객 통지가 뒤따라 실패하는 식이다. 따라서 alarm 하나를 닫는 것보다 연결된 evidence chain을 복원하는 일이 중요하다.
측정이 실패하면 정상과 장애를 구분할 기준이 사라진다
측정 실패의 첫 징후는 값이 없는 것이지만 더 위험한 경우는 값이 그럴듯한 것이다. slice identifier가 다른 집계에 섞이거나, RAN·transport·core의 clock이 어긋나거나, 고객의 사용 지역과 다른 관측점만 보거나, 변경 전후 aggregation window가 달라질 수 있다. 이때 dashboard는 녹색이어도 고객 application은 느릴 수 있고, 반대로 짧은 spike가 계약상 위반이 아닌데도 incident로 확대될 수 있다.
GSMA NG.116 V10.0은 performance monitoring 속성에서 KQI는 end-to-end service performance와 quality를, KPI는 network performance를 반영한다고 구분한다. 또 Network Slice Customer와 Network Operator가 사용할 수 있는 monitoring 항목을 template 속성으로 다룬다. 이는 고객 경험과 망 지표를 연결할 공통 vocabulary가 필요하다는 근거이지, 두 값이 언제나 일치한다는 보증이 아니다.
즉시 조치는 새로운 결론을 서두르는 것이 아니라 evidence를 얼리는 일이다. alarm 원본, measurement definition, query, time zone, granularity, 대상 식별자, 누락률, 관련 change와 고객 측 timestamp를 보존한다. 그 뒤 동일 정의로 다시 계산할 수 있어야 한다. 관측 체계 자체가 의심스러우면 자동 action의 입력 신뢰도도 낮아졌으므로 실행 범위를 축소하거나 멈춰야 한다.
정책과 자동화가 실패하면 빠른 loop가 빠른 오판이 된다
여러 closed loop가 같은 자원에 action을 내릴 수 있다. 한 loop는 특정 slice의 latency를 낮추려 resource를 늘리고, 다른 loop는 전체 utilization을 낮추려 자원을 회수할 수 있다. 각 목표만 보면 합리적이지만 실행 순서, 우선순위, 보호 조건과 공통 arbitration이 없으면 oscillation이나 다른 서비스의 regression이 생긴다.
ETSI GS ZSM 009-1은 closed loop가 여러 management domain에 걸칠 수 있고 data collection과 action execution이 서로 다른 domain에서 이뤄질 수 있다고 설명한다. 또한 governance service에 lifecycle·policy·goal 관리, issue resolution과 escalation을 두고, pre-execution coordination에는 서로 다른 loop의 conflicting action plan 통지를 포함한다. 이 근거가 말해 주는 것은 자동화가 많을수록 조정이 덜 필요하다는 것이 아니라, action 전 충돌 탐지와 해결 권한이 별도 capability로 필요하다는 점이다.
정책 failure의 즉시 조치는 affected object에 대한 자동 실행을 중지하고, 마지막으로 검증된 policy·model·configuration 조합을 고정하는 것이다. 어떤 목표가 상위인지, 어떤 slice를 보호해야 하는지, 누가 예외를 승인하는지 확인하기 전에는 action을 반복하지 않는다. AI confidence가 높아도 policy conflict를 정당화하지 못한다.
변경 failure는 API 성공과 서비스 성공을 혼동할 때 커진다
configuration API가 200 또는 success를 반환했다는 것은 요청을 받았다는 증거일 수는 있어도 고객 서비스가 회복됐다는 증거는 아니다. 변경이 일부 domain에만 적용됐거나 dependency가 늦게 수렴하거나, 다른 slice의 shared resource를 압박하거나, rollback에 필요한 이전 state가 사라질 수 있다. change ticket가 닫혀도 service incident는 열려 있을 수 있다.
그래서 변경 전에는 대상·버전·dependency·영향 범위·관측 기간·abort threshold·rollback artifact를 묶어야 한다. 변경 중에는 실행 주체와 실제 적용 상태를 분리해 기록한다. 변경 뒤에는 원래 문제의 KPI뿐 아니라 보호해야 할 다른 slice와 고객 KQI를 함께 확인한다. 재검증이 끝나기 전의 ‘적용 성공’은 terminal state가 아니다.
rollback도 버튼 하나가 아니다. stateful session, schema·data migration, policy version, model feature, cross-domain dependency에 따라 완전 복원이 불가능할 수 있다. 따라서 rollback 가능성은 incident 때 처음 묻는 질문이 아니라 change admission 조건이어야 한다. 되돌릴 수 없다면 더 작은 blast radius, canary, 별도 고객 동의와 수동 gate가 필요하다.
책임과 조직이 실패하면 아는 사람은 있어도 결정하는 사람이 없다
Network Slicing은 RAN, transport, core, cloud, orchestration, BSS/OSS, security, customer operations를 가로지를 수 있다. 각 domain dashboard가 자기 구간은 정상이라고 말해도 end-to-end service는 실패할 수 있다. 더 큰 문제는 기술 담당자가 원인 후보를 찾아도 누가 전체 변경을 중지하고 누가 고객에게 영향 범위를 알릴지 정해져 있지 않은 경우다.
GSMA NG.116은 Communication Service Customer·Provider, Network Operator, Network Slice Customer·Provider 역할을 구분하고 책임을 명확히 정의할 필요가 있다고 설명한다. 실제 조직에서는 한 회사가 여러 역할을 맡거나 여러 회사가 한 서비스를 나눠 제공할 수 있다. 역할 명칭만 적는 것으로 충분하지 않다. incident commander, measurement owner, policy owner, change·rollback owner, customer communication owner와 최종 인수 기준을 시간대별로 호출 가능하게 만들어야 한다.
운영 조직의 복구는 회의방을 여는 데서 끝나지 않는다. 하나의 incident timeline, 공통 service identifier, 현재 가설과 반증 evidence, 승인된 action, 다음 판단 시각을 공유해야 한다. domain별 ticket가 서로 다른 시간을 쓰거나 고객명이 기술 식별자로 이어지지 않으면 같은 사건을 여러 사건처럼 처리하게 된다.
고객 약속은 기술 복구 뒤에도 따로 닫아야 한다
내부 KPI가 정상 범위로 돌아왔다고 고객 사건이 자동으로 종료되지는 않는다. 고객이 합의한 서비스 지역, 시간, 단말·application 범위와 측정 방식으로 회복을 확인해야 한다. 고객 측 buffer, application server, enterprise LAN 같은 외부 요인이 있을 수 있지만, 이를 근거 없이 책임 전가의 결론으로 사용해서도 안 된다. 양쪽 evidence를 같은 timeline과 계약 정의에 맞춰 비교해야 한다.
SLA/고객 영향 층에서 필요한 것은 blame이 아니라 traceability다. 어떤 promise가 적용됐고, 어느 KQI/KPI가 어떤 window에서 벗어났으며, 언제 고객에게 알렸고, 임시 완화와 최종 복구를 누가 확인했는지 남긴다. remedy나 책임 배분은 계약과 승인된 절차의 문제이므로 이 글이 일반 결론을 내리지 않는다. 다만 기술 복구 기록만으로 고객 인수와 분쟁 종료를 대체할 수 없다는 운영 경계는 분명하다.
복구는 원인을 맞히는 일이 아니라 안전하게 다시 연결하는 일이다
대체 설명 원인 후보를 서비스 영향과 연결하고, 독립된 evidence로 탐지한 뒤 자동 변경을 중지하거나 rollback하며, 같은 측정 정의와 고객 범위로 재검증하는 다섯 단계 흐름이다. 모바일에서는 위에서 아래 한 열로 문구 단위로 읽힌다. 실제 표준 message sequence, 상용 망 topology, 특정 사업자의 장애 절차가 아니다.
- 1. 원인측정·정책·변경·dependency·ownership의 단절 후보를 기록한다.
- 2. 영향affected slice·지역·시간·고객 업무와 보호할 다른 서비스를 한정한다.
- 3. 탐지원본 telemetry·change record·고객 evidence를 같은 timeline에서 교차 확인한다.
- 4. 중지/rollback자동 action을 멈추고 blast radius를 고정한 뒤 검증된 state로 되돌린다.
- 5. 재검증동일 KPI/KQI·window·대상으로 회복과 regression을 확인하고 고객 인수를 분리한다.
이 흐름에서 root cause는 처음부터 확정하지 않는다. 조사 중인 가설, 확인된 원인, 기여 요인과 미확인 영역을 나눠 기록한다. 잘못된 확신으로 복구 action을 반복하면 원래 evidence가 사라지고 영향 범위가 커질 수 있다. 탐지는 독립된 signal 두 개 이상과 change correlation을 요구할 수 있지만, 구체 threshold는 서비스별 정책으로 정해야 한다.
중지와 rollback 뒤에는 ‘원래 값으로 돌아왔는가’뿐 아니라 ‘원래 고객 약속이 다시 충족되는가’를 확인한다. rollback 자체가 새로운 regression을 만들지 않았는지, 다른 slice의 resource와 policy가 정상인지, 관측 체계가 같은 정의를 사용했는지도 본다. 이 재검증을 통과하지 않은 recovery는 임시 완화일 수는 있어도 완료는 아니다.
실패에 강한 운영은 장애가 없는 운영과 다르다
실패에 강한 운영은 모든 fault를 예방한다고 약속하지 않는다. 대신 measurement definition을 재현할 수 있고, policy conflict를 action 전에 드러내며, change의 blast radius와 rollback을 준비하고, 책임자가 중지 결정을 내릴 수 있고, 고객 약속까지 별도로 재검증할 수 있게 한다. 자동화와 AI는 이 연결을 빠르게 만들 수 있지만, 연결의 의미와 권한을 스스로 정하지는 않는다.
특정 통신사의 상용 장애를 근거 없이 이 구조의 증거로 삼지 않았다. 3GPP KPI·assurance 규격, ETSI closed-loop governance, GSMA slice template은 필요한 구성요소를 설명한다. “실패는 연결 단절”이라는 진단과 표·복구 도식은 필자의 운영 분석이며, 실제 incident에서는 해당 사업자의 계약·architecture·runbook·evidence로 다시 검증해야 한다.
이 글은 망중립성 판단, 정부와 통신사의 책임 배분, 5G SA에서 6G로 넘어가야 한다는 결론을 내리지 않는다. 그런 정책·거버넌스·세대 전환의 질문에 앞서, 여기서는 기술 failure와 운영·조직 failure, SLA/고객 영향이 어떻게 구분되고 다시 연결돼야 하는지만 다뤘다.
독자용 참고자료
- 3GPP TS 28.536 specification portal: communication service assurance와 closed control loop의 문서 상태·버전을 확인할 수 있다.
- ETSI TS 128 554 V19.5.1 PDF: 5G end-to-end KPI의 대상·단위·집계 정의를 확인할 수 있다.
- ETSI GS ZSM 009-1 V1.1.1 PDF: closed-loop governance·coordination·conflicting action plan을 다룬다.
- GSMA NG.116 V10.0 PDF: slice 역할, template 속성과 performance monitoring의 KQI/KPI 경계를 확인할 수 있다.